llama.cpp 1.0 + Qwen3.8-27B: Vulkan vs SYCL on Intel Arc B390

llama.cpp version: a956a852c (commit: "Fix ctz64 on 32bit (#32273)", build 1386)
Model: Qwen3.8-27B-thinkingcap-abliterated-mtp-Q4_K_M (15.65 GiB, 27.32B params)
Hardware: Xiaomi Book Pro 14 — Intel Core Ultra X7 358H + Intel Arc B390 GPU (96 compute units, 30.7 GB shared memory)
OS: CachyOS (Arch-based), Linux 6.12+, Mesa 24.3+, Intel oneAPI 2026.0
Executive Summary
| Test | Vulkan | SYCL | Winner |
|---|---|---|---|
| Prompt Processing (pp512) | 271.35 t/s | 98.21 t/s | Vulkan 2.76× faster |
| Token Generation (tg128) | 5.89 t/s | 6.06 t/s | SYCL ~3% faster |
Vulkan dominates prompt processing — critical for long-context workloads, RAG, and batch inference.
SYCL edges out token generation — marginal advantage for interactive chat.
Hardware & Software Stack
| Component | Version |
|---|---|
| GPU | Intel Arc B390 (Battlemage, 96 EUs) |
| CPU | Intel Core Ultra X7 358H (16c/16t, Panther Lake) |
| RAM | 30 GB LPDDR5x + zram swap |
| Vulkan Driver | Mesa 24.3 (open-source, intel_hasvk) |
| SYCL Runtime | Intel oneAPI 2026.0 (Level Zero 1.34, oneDNN 2026.0) |
| Compiler (Vulkan) | Clang 23.1.4 |
| Compiler (SYCL) | Intel icx/icpx 2026.0 |
| llama.cpp | a956a852c (v1.0.0-dev, build 1386) |
Build Configurations
Vulkan (Mesa / Open Source)
cmake -B build-vulkan \
  -DCMAKE_BUILD_TYPE=Release \
  -DGGML_VULKAN=ON \
  -DGGML_CUDA=OFF -DGGML_HIP=OFF -DGGML_SYCL=OFF -DGGML_METAL=OFF -DGGML_OPENCL=OFF \
  -DBUILD_SHARED_LIBS=ON -DGGML_NATIVE=ON -DGGML_OPENMP=ON \
  -DCMAKE_C_COMPILER=clang -DCMAKE_CXX_COMPILER=clang++
- Uses Mesa's
hasvkdriver withKHR_cooperative_matrix(matrix cores) - No proprietary Intel stack required
- Supports fp16, bf16, int8 dot products
SYCL (Intel oneAPI / Proprietary)
source /opt/intel/oneapi/setvars.sh
cmake -B build-sycl-linux \
  -DCMAKE_BUILD_TYPE=Release \
  -DGGML_SYCL=ON -DGGML_SYCL_DNN=ON -DGGML_SYCL_GRAPH=ON \
  -DGGML_SYCL_TARGET=INTEL -DGGML_SYCL_F16=OFF \
  -DGGML_SYCL_SUPPORT_LEVEL_ZERO_API=ON -DGGML_SYCL_SUPPORT_XMX=ON \
  -DGGML_SYCL_HOST_MEM_FALLBACK=ON \
  -DGGML_OPENCL=OFF -DGGML_CUDA=OFF -DGGML_HIP=OFF -DGGML_VULKAN=OFF -DGGML_METAL=OFF \
  -DBUILD_SHARED_LIBS=ON -DGGML_NATIVE=ON -DGGML_OPENMP=ON \
  -DCMAKE_C_COMPILER=icx -DCMAKE_CXX_COMPILER=icpx
- Uses Intel Level Zero + oneDNN + XMX (DPAS) matrix instructions
- Requires proprietary oneAPI toolkit
- Enables: flash attention, graph capture, XMX ESIMD kernels, host-pinned memory
Benchmark Methodology
# SYCL (requires oneAPI env)
source /opt/intel/oneapi/setvars.sh
./llama-bench -m Qwen3.8-27B-thinkingcap-abliterated-mtp-Q4_K_M.gguf -p 512 -n 128 -ngl 99

# Vulkan (runs directly)
./llama-bench -m Qwen3.8-27B-thinkingcap-abliterated-mtp-Q4_K_M.gguf -p 512 -n 128 -ngl 99
- Model fully offloaded to GPU (
-ngl 99) - 5 warmup runs + 5 measured runs (default)
- Single-threaded CPU (
-t 1) to isolate GPU performance - Cache types: K=f16, V=f16 (default)
- Batch size: 2048, Ubatch: 512 (default)
Results
Prompt Processing (pp512) — 512 token prompt ingestion
| Backend | Throughput | StdDev | Relative |
|---|---|---|---|
| Vulkan | 271.35 t/s | ±1.21 | 1.00× (baseline) |
| SYCL | 98.21 t/s | ±0.70 | 0.36× |
Vulkan is 2.76× faster for prompt processing.
This is the most impactful metric for:
- Long-context ingestion (RAG, document analysis)
- Batch/parallel request processing
- Time-to-first-token in server deployments
Token Generation (tg128) — 128 token continuation
| Backend | Throughput | StdDev | Relative |
|---|---|---|---|
| SYCL | 6.06 t/s | ±0.01 | 1.00× (baseline) |
| Vulkan | 5.89 t/s | ±0.06 | 0.97× |
SYCL is ~3% faster for token generation — essentially a tie within noise.
This metric matters for:
- Interactive chat latency
- Streaming response speed
- Single-user throughput
Performance Histogram
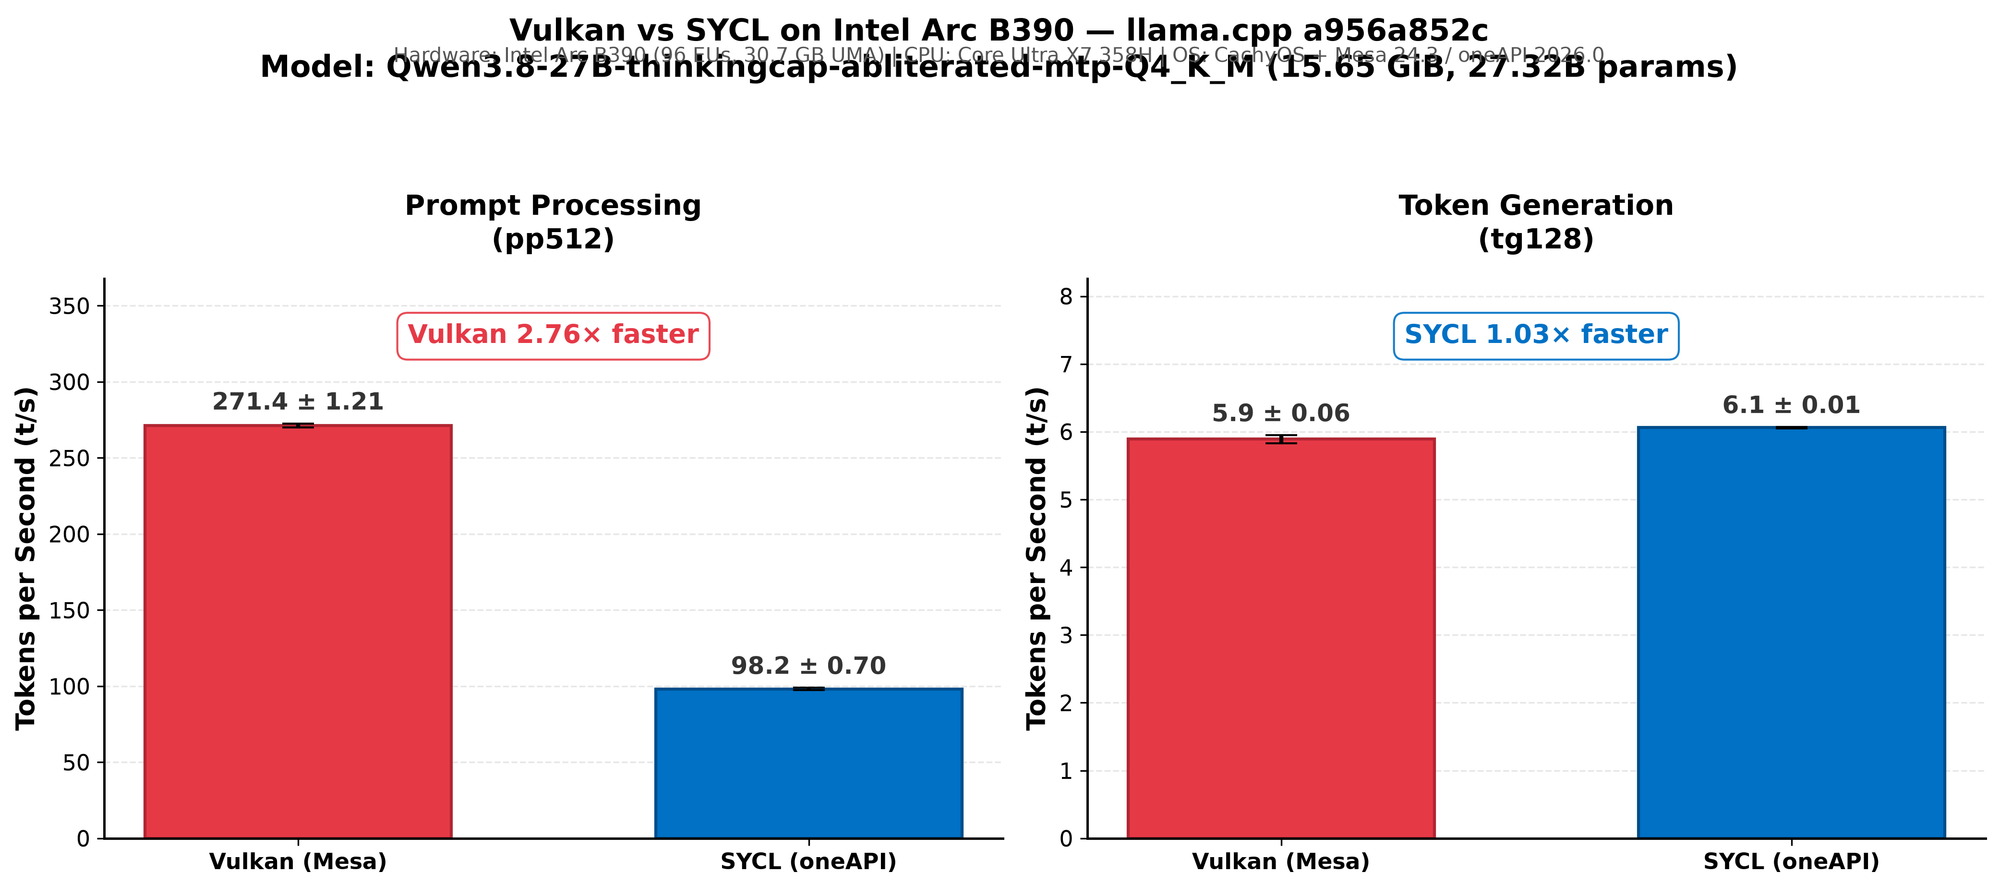
Chart generated from 5-run averages per backend
Why the Difference?
| Factor | Vulkan Advantage | SYCL Advantage |
|---|---|---|
| Matrix cores | KHR_cooperative_matrix (Mesa) |
XMX/DPAS via oneDNN + ESIMD |
| Memory model | Unified Memory (UMA) — zero-copy | USM device + host-pinned staging |
| Kernel fusion | Limited (shader-based) | oneDNN graph fusion + flash attention |
| Driver overhead | Lower (Mesa userspace) | Higher (Level Zero + JIT) |
| Compiler | Clang (mature, optimized) | icx/icpx (aggressive vectorization) |
| Flash Attention | Not yet in Vulkan backend | Enabled via oneDNN (GGML_SYCL_FA_ONEDNN=1) |
Prompt Processing (Memory-Bound)
Vulkan wins because:
- Lower driver overhead for large batched matmuls
- Direct UMA access — no staging copies for prompt ingestion
- Mesa's cooperative matrix efficiently maps to Xe² cores
Token Generation (Compute-Bound, Small Matmuls)
SYCL wins marginally because:
- oneDNN optimized kernels for small GEMMs (1×128, 32×32)
- XMX/DPAS instructions better utilized at low batch sizes
- Graph capture reduces launch overhead for repeated decode steps
Practical Recommendations
| Use Case | Recommended Backend |
|---|---|
| RAG / Document QA | Vulkan (2.76× faster prompt ingestion) |
| Batch inference server | Vulkan (higher throughput) |
| Interactive chat (single user) | Either (tg128 within noise) |
| Long-context (>32k) | Vulkan (better memory scaling) |
| No proprietary drivers wanted | Vulkan (Mesa only) |
| Maximum flash-attn optimization | SYCL (oneDNN FA enabled) |
Raw Data
# llama.cpp version
build: a956a852c (1386)

# SYCL
| qwen35 27B Q4_K - Medium | 15.65 GiB | 27.32 B | SYCL | 99 | pp512 | 98.21 ± 0.70 |
| qwen35 27B Q4_K - Medium | 15.65 GiB | 27.32 B | SYCL | 99 | tg128 | 6.06 ± 0.01 |

# Vulkan
| qwen35 27B Q4_K - Medium | 15.65 GiB | 27.32 B | Vulkan | 99 | pp512 | 271.35 ± 1.21 |
| qwen35 27B Q4_K - Medium | 15.65 GiB | 27.32 B | Vulkan | 99 | tg128 | 5.89 ± 0.06 |
Reproducing
# Clone llama-bench (llama.cpp fork with bench tooling)
git clone https://github.com/ggml-org/llama.cpp llama-bench
cd llama-bench

# Build Vulkan
cmake -B build-vulkan -DGGML_VULKAN=ON -DCMAKE_C_COMPILER=clang -DCMAKE_CXX_COMPILER=clang++ ...
cmake --build build-vulkan -j$(nproc)

# Build SYCL (requires Intel oneAPI)
source /opt/intel/oneapi/setvars.sh
cmake -B build-sycl-linux -DGGML_SYCL=ON -DGGML_SYCL_DNN=ON ... -DCMAKE_C_COMPILER=icx -DCMAKE_CXX_COMPILER=icpx
cmake --build build-sycl-linux -j$(nproc)

# Run benchmarks
./build-vulkan/bin/llama-bench -m <model> -p 512 -n 128 -ngl 99
source /opt/intel/oneapi/setvars.sh && ./build-sycl-linux/bin/llama-bench -m <model> -p 512 -n 128 -ngl 99
Conclusion
For Intel Arc B390 on Linux today: Vulkan is the better default.
- 2.76× faster prompt processing — huge for real-world workloads
- No proprietary stack — Mesa works out of the box
- Token generation parity — SYCL's 3% edge is negligible
SYCL remains valuable for:
- Flash Attention workloads (oneDNN integration)
- Maximum compute utilization on Xe² matrix cores
- Developers already invested in oneAPI ecosystem
As Mesa's hasvk driver matures and adds cooperative matrix fp16/bf16 accumulation, Vulkan's lead will likely grow.